De meest fundamentele techniek
In de vorige post besprak ik zes technieken om AI-gegenereerde output te testen, en één ervan komt terug in elk gesprek dat ik voer met QA-leads en IT-managers: evaluatie binnen acceptabele marges, in plaats van exacte matches.
Het is de meest fundamentele techniek van allemaal. Als je team maar één nieuwe gewoonte aanleert bij het testen van AI, dan is het deze. Laten we dus even vertragen en stap voor stap bekijken hoe dit er in de praktijk uitziet.
Waarom "de oude manier" niet meer werkt
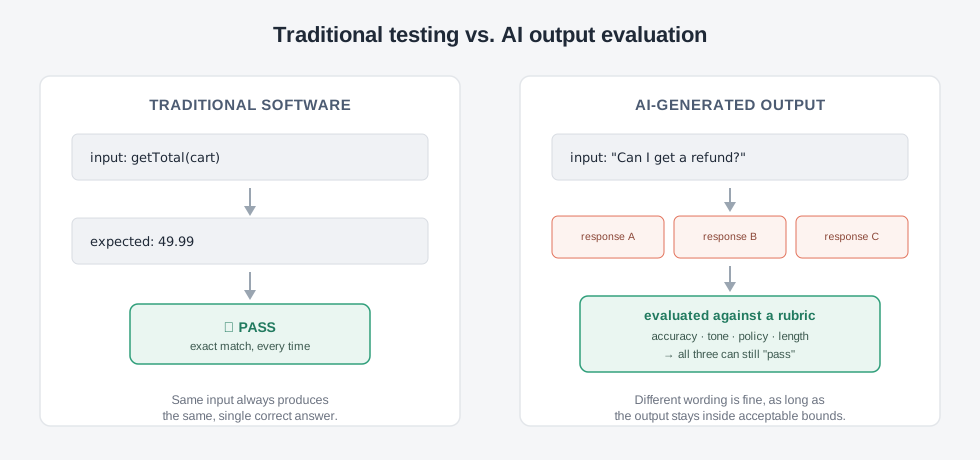
Stel je een gewone softwaretest voor: je roept een functie aan, je weet precies wat die moet teruggeven, en je vergelijkt de twee. Komt het overeen? Groen vinkje. Zo niet? Rood kruisje. Dit werkt omdat traditionele software deterministisch is: dezelfde input, dezelfde output.
AI-gegenereerde output speelt niet volgens die regel. Vraag een model drie keer om te antwoorden op "Kan ik een terugbetaling krijgen?", en je krijgt mogelijk drie verschillend geformuleerde, maar even correcte antwoorden. Als je test op zoek is naar één exacte string, laat die het tweede en derde antwoord falen, ook al is er eigenlijk niets mis mee.
Dit is de verschuiving in een notendop:
Verschuiving binnen testing
Let op wat er rechts veranderd is. We vragen niet langer "komt dit overeen met één specifiek antwoord?" maar "valt dit binnen een verzameling acceptabele antwoorden?" Dat is het hele idee achter rubric-gebaseerde evaluatie binnen marges.
Wat betekent "acceptabel" dan precies?
Dit is het punt waar mensen over struikelen, begrijpelijk, want "acceptabel" klinkt vaag. Maar dat hoeft het niet te zijn. In de praktijk vertaal je het naar een kleine set concrete, controleerbare criteria, elk met een eigen lat om over te gaan. Bijvoorbeeld:
- Nauwkeurigheid: Is de informatie feitelijk correct en consistent met jouw bron van waarheid?
- Volledigheid: Beantwoordt het daadwerkelijk wat er gevraagd werd, zonder iets essentieels weg te laten?
- Tone of voice: Past het bij de stem die je wilt (empathisch, formeel, beknopt, on-brand)?
- Beleidsconformiteit: Blijft het binnen juridische, regelgevende of bedrijfsmatige grenzen? (Terugbetalingsbeloftes, medische claims en financieel advies zijn hier klassieke gevarenzones.)
- Formaat en lengte: Past het binnen de beperkingen van waar het getoond wordt? Een chatbericht, een e-mail, een samenvatting van één regel, enzovoort.
Hoe dit eruitziet als je het echt draait
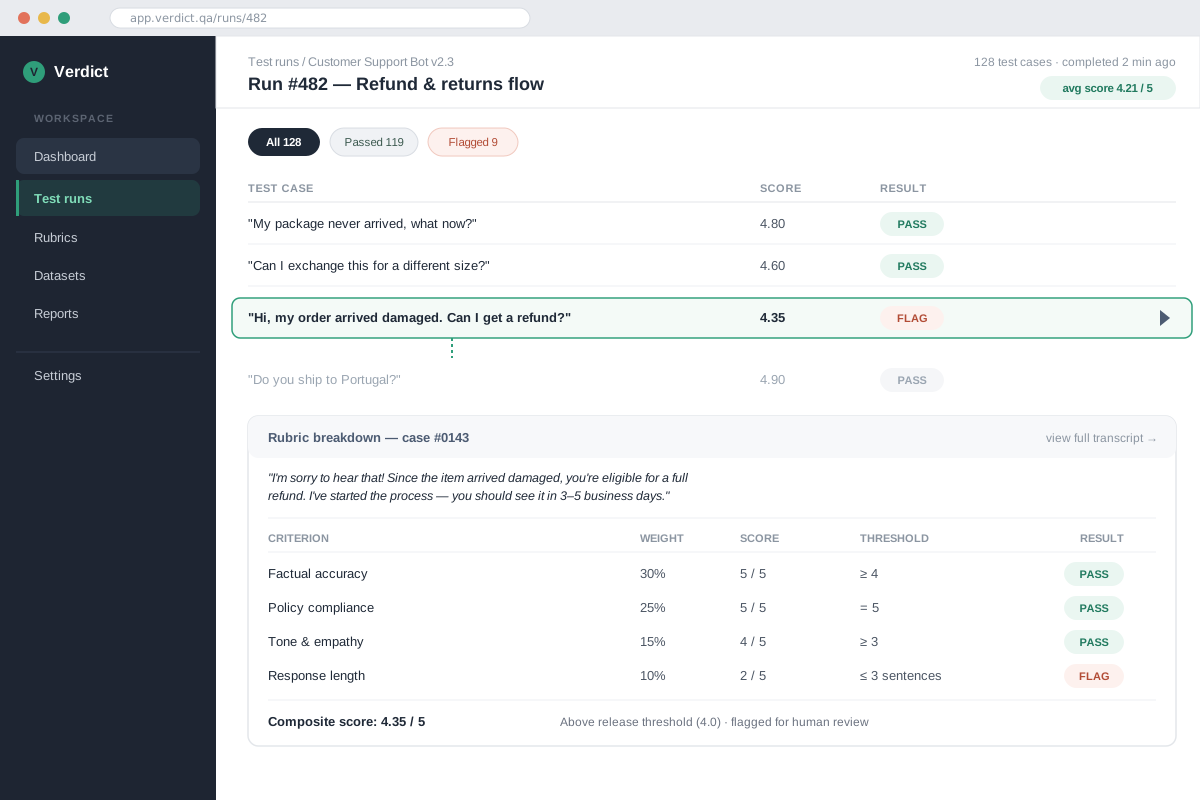
Zo zou dat eruit kunnen zien in een evaluatietool, voor een batch testcases uitgevoerd tegen een klantenservicebot. Eén case is gemarkeerd en uitgeklapt om de rubric-uitsplitsing te tonen:
AI testing in de realiteit
Een paar dingen die het benoemen waard zijn, want het zijn precies de details die dit echt nuttig maken in plaats van gewoon een mooiere checklist:
Elk criterium heeft zijn eigen slaaggrens. "Beleidsconformiteit" wordt strenger beoordeeld (moet een perfecte 5 scoren) dan "tone of voice" (een 3 of hoger volstaat). Niet alles verdient dezelfde striktheid, en doen alsof dat wel zo is, is hoe rubrics ofwel te rigide ofwel te soepel worden.
Criteria worden gewogen. Feitelijke nauwkeurigheid en beleidsconformiteit wegen hier zwaarder dan de lengte van het antwoord, dus tellen ze zwaarder mee in het eindcijfer. Die weging moet je werkelijke bedrijfsrisico weerspiegelen, niet uit gemakzucht gelijk verdeeld zijn.
Eén gemarkeerd criterium laat niet per se het hele antwoord falen. In het voorbeeld overschrijdt het antwoord de lengterichtlijn, maar al de rest is sterk. De samengestelde score zit nog ruim boven de releasedrempel. Dit is belangrijk: zo kan een antwoord doorgaan terwijl het probleem toch zichtbaar wordt gemaakt voor een menselijke blik, in plaats van bij elke imperfectie een alles-of-niets-poort af te dwingen.
Er is nog steeds een eindoordeel. Al die flexibiliteit betekent niet dat "alles mag". Je eindigt nog altijd met een samengestelde score en een duidelijke drempel voor wat uitgerold mag worden. De nuance zit in hoe je daar komt, niet in de vraag of er aan het einde een beslissing valt.
Je eigen rubric opbouwen
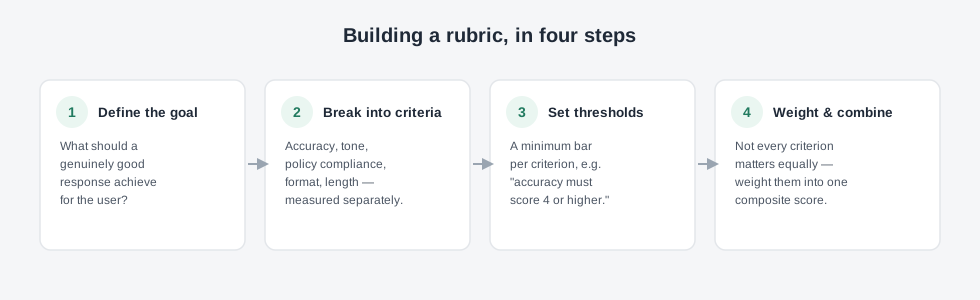
Als je er voor het eerst een opzet, helpt het om in een specifieke volgorde te werken in plaats van criteria uit de losse pols op te sommen:
De juiste stappen
Vertrek vanuit het resultaat dat er echt toe doet ("de klant vertrekt met het juiste antwoord en voelt zich gehoord"), niet vanuit een generieke checklist die ergens vandaan gekopieerd is. Ontleed dat resultaat vervolgens in criteria die je daadwerkelijk kunt meten, bepaal per criterium een lat, en beslis ten slotte hoeveel elk criterium moet meetellen in het eindoordeel. Meteen naar "laten we wat criteria opsommen" springen is de meest voorkomende manier waarop deze rubrics oppervlakkig worden of losstaan van wat het bedrijf echt belangrijk vindt.
Hoe dit geautomatiseerd wordt
Dit alles is nutteloos als een mens elke output moet lezen en handmatig scoren. Dat ondergraaft het hele doel zodra je AI-systeem meer dan een handvol interacties per dag afhandelt. In de praktijk automatiseren teams deze rubric-gebaseerde scoring op een paar elkaar overlappende manieren:
- Regelgebaseerde checks voor de objectieve zaken: lengtebeperkingen, verplichte disclaimers, verboden woorden of zinnen, opmaakregels. Deze zijn goedkoop, snel en deterministisch, ook al is wat ze controleren dat niet.
- Semantische gelijkenisscore voor de vagere criteria: de output van de AI vergelijken met een referentieantwoord, niet woord voor woord, maar op betekenis, via embedding-gebaseerde vergelijkingen.
- Een tweede AI-model als beoordelaar, dat de rubric toepast zoals een menselijke reviewer dat zou doen, maar op een schaal die geen enkel menselijk team aankan. Dit wordt vaak "LLM-as-a-judge" genoemd, en het is krachtig genoeg om een eigen deep dive te verdienen. Die volgt als volgende in deze reeks.
Best practices voor je hiermee uitrolt
Een korte lijst om bij de hand te houden als je dit in je organisatie introduceert:
- Schrijf de rubric samen met de mensen die het risico begrijpen, niet alleen met de testers. Juridische, compliance- en productteams zien vaak faalscenario's die QA alleen zou missen.
- Houd de criteria beperkt en betekenisvol. Vijf gerichte criteria die je echt opvolgt, verslaan er vijftien waar je nooit meer naar kijkt.
- Herbekijk drempels regelmatig. Wat bij de lancering als "goed genoeg" gold, houdt misschien geen stand zodra het systeem meer randgevallen of gesprekken met hogere inzet afhandelt.
- Log alles, niet alleen de mislukkingen. Geslaagde antwoorden die net op de rand van een drempel zitten, zijn vaak je vroegste waarschuwingssignaal voor drift.
- Behandel een markering als informatie, niet automatisch als een blokkade. Het doel is zichtbaarheid, geen verlamming.
Waar dit ons brengt
Rubric-gedreven evaluatie binnen marges is het fundament waarop al de rest in AI-testing gebouwd wordt. Het is wat het mogelijk maakt om iets zinnigs te zeggen over de kwaliteit van een AI-systeem, zelfs wanneer dat systeem dingen elke keer anders mag verwoorden.
Het is bovendien, eerlijk gezegd, de techniek met de beste verhouding tussen inspanning en opbrengst. Je hebt geen exotische infrastructuur nodig om te beginnen — met een heldere rubric, een paar drempels en de discipline om ze consequent toe te passen komen de meeste teams al een heel eind.
Milan Meuleman
Business development & sales
Contacteer Refleqt vandaag
Wil je meer grip krijgen op softwarekwaliteit, testautomatisatie of performance? We bekijken graag samen hoe we jouw team kunnen ondersteunen met een aanpak die werkt in de praktijk.