La técnica fundamental
En el post anterior hablé de seis técnicas para probar los resultados generados por la IA, y una de ellas sobresale en todas las conversaciones que mantengo con los responsables de control de calidad y los directores de TI: la evaluación dentro de unos márgenes aceptables, en lugar de buscar coincidencias exactas.
Es la técnica más fundamental de todas. Si tu equipo tiene que aprender un solo hábito nuevo a la hora de probar la IA, que sea este. Así que detengámonos un momento y veamos paso a paso cómo se aplica esto en la práctica.
Por qué el método tradicional ya no funciona
Imagina una prueba de software habitual: llamas a una función, sabes exactamente qué debe devolver y comparas ambos resultados. ¿Coinciden? Marca verde. ¿No? Marca roja. Esto funciona porque el software tradicional es determinista: la misma entrada produce la misma salida.
La salida generada por IA no sigue esa regla. Si le pides a un modelo tres veces que responda a «¿Puedo obtener un reembolso?», es posible que obtengas tres respuestas formuladas de manera diferente, pero igualmente correctas. Si tu prueba busca una cadena exacta, hará que la segunda y la tercera respuesta fallen, aunque en realidad no haya erróneo en ellas.
Este es el cambio en pocas palabras:
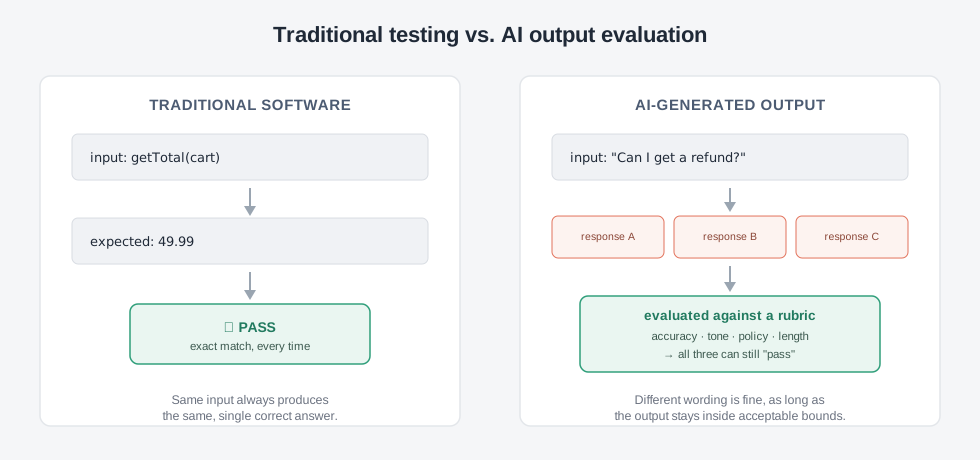
Cambio de paradigma.
¿Qué significa exactamente márgenes aceptables?
Este es el punto en el que la gente se equivoca, lo cual es comprensible, ya que «aceptable» suena vago. Pero no tiene por qué serlo. En la práctica, se traduce en un pequeño conjunto de criterios concretos y verificables, cada uno con su propio umbral. Por ejemplo:
- Exactitud: ¿Es la información objetivamente correcta y coherente con tu fuente de referencia?
- Exhaustividad: ¿Responde realmente a lo que se ha preguntado, sin omitir nada esencial?
- Tono: ¿Se ajusta al tono que deseas (empático, formal, conciso, ajeno a la marca)?
- Cumplimiento de las políticas: ¿Se mantiene dentro de los límites legales, normativos o empresariales? (Las promesas de reembolso, las afirmaciones médicas y el asesoramiento financiero son zonas de riesgo clásicas en este sentido).
- Formato y longitud: ¿Se ajusta a las limitaciones del lugar donde se muestra? Un mensaje de chat, un correo electrónico, un resumen de una sola línea, etcétera.
Ninguno de estos criterios tiene una única formulación «correcta». Pero cada uno de ellos es medible. Ahí está el truco: no renuncias al rigor, solo lo trasladas de «coincidencia de texto» a «cumplimiento de criterios».
¿Cómo ponerlo en práctica?
Así es como sería una herramienta de evaluación, para un conjunto de casos de prueba ejecutados con un bot de atención al cliente. Se ha marcado un caso y se ha desplegado para mostrar el desglose por categorías:
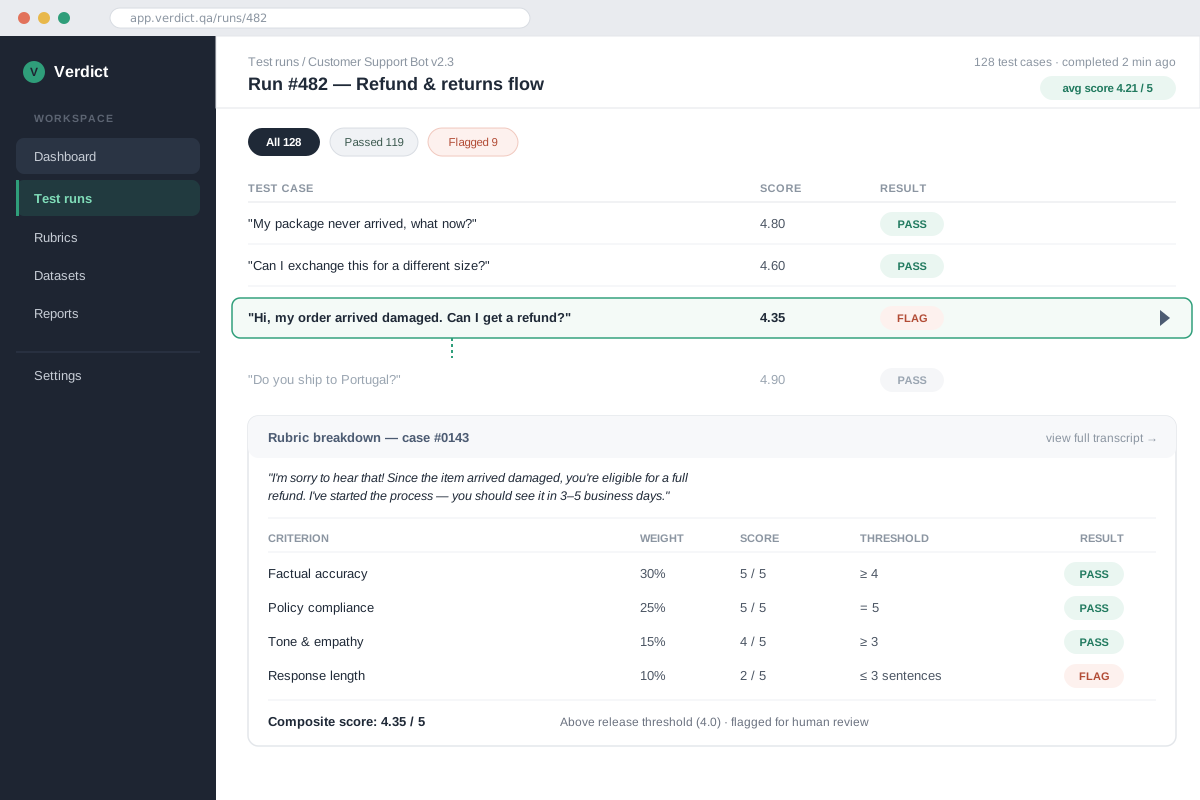
Testing de IA en la realidad
Hay un par de cosas que vale la pena mencionar, ya que son precisamente los detalles los que hacen que esto resulte realmente útil, en lugar de ser simplemente una lista de verificación más bonita:
- Cada criterio tiene su propio umbral de aprobación. La «conformidad con la política» se evalúa con mayor rigor (debe obtener un 5 perfecto) que el «tono de voz» (basta con un 3 o más). No todo merece el mismo rigor, y pretender lo contrario es lo que hace que las rúbricas resulten o bien demasiado rígidas o bien demasiado flexibles.
- Los criterios se ponderan. La precisión factual y el cumplimiento de las políticas tienen más peso que la extensión de la respuesta, por lo que influyen más en la nota final. Esa ponderación debe reflejar el riesgo real de la empresa, no distribuirse por igual por comodidad.
- Un criterio fallado no hace que toda la respuesta sea necesariamente incorrecta. En el ejemplo, la respuesta supera la directriz de extensión, pero todo lo demás es sólido. La puntuación compuesta sigue estando muy por encima del umbral de publicación. Esto es importante: así, una respuesta puede pasar la evaluación, al tiempo que el problema queda visible para el ojo humano, en lugar de imponer una puerta de «todo o nada» ante cada imperfección.
- Sigue habiendo una valoración final. Toda esa flexibilidad no significa que «todo valga». Al final, siempre se obtiene una puntuación compuesta y un umbral claro sobre lo que se puede publicar. El matiz está en cómo se llega a ello, no en si al final se toma una decisión.
Crea tu propia rúbrica
Cuando lo elaboras por primera vez, es útil seguir un orden concreto en lugar de enumerar criterios de forma aleatoria:
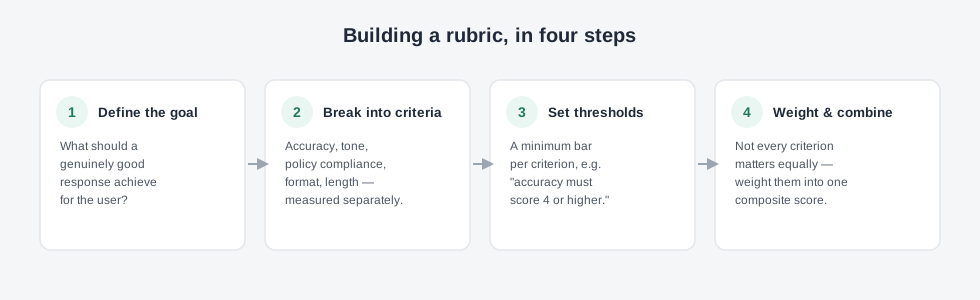
Pasos para construir tu rúbrica
Parte del resultado que realmente importa («el cliente se va con la respuesta adecuada y se siente escuchado»), no de una lista de verificación genérica copiada de algún sitio. A continuación, desglosa ese resultado en criterios que se puedan medir realmente, establece un umbral para cada criterio y, por último, decide qué peso debe tener cada criterio en la valoración final. Saltarse directamente a «vamos a enumerar algunos criterios» es la forma más habitual en que estas rúbricas se vuelven superficiales o se desvinculan de lo que la empresa realmente considera importante.
¿Cómo se automatiza esto?
Todo esto es inútil si una persona tiene que leer cada resultado y puntuarlo manualmente. Eso socava el objetivo mismo en cuanto tu sistema de IA gestiona más de un puñado de interacciones al día. En la práctica, los equipos automatizan esta puntuación basada en rúbricas de varias formas que se solapan:
- Comprobaciones basadas en reglas para los aspectos objetivos: límites de longitud, avisos legales obligatorios, palabras o frases prohibidas, normas de formato. Son reglas baratas, rápidas y deterministas, aunque lo que comprueban no lo sea.
- Puntuación de similitud semántica para los criterios más vagos: comparar el resultado de la IA con una respuesta de referencia, no palabra por palabra, sino en cuanto al significado, mediante comparaciones basadas en el mensaje global.
- Un segundo modelo de IA como evaluador, que aplica la rúbrica tal y como lo haría un revisor humano, pero a una escala que ningún equipo humano puede asumir. A esto se le suele llamar «LLM-as-a-judge», y es lo suficientemente potente como para merecer un análisis en profundidad propio. Este será el siguiente tema de esta serie.
- La mayoría de las configuraciones maduras combinan las tres: las comprobaciones baratas basadas en reglas detectan primero los problemas más evidentes, y las comprobaciones más caras, semánticas o evaluadas por IA, se encargan de los matices.
Mejores prácticas
Una breve lista que conviene tener a mano al introducir esto en tu organización:
- Elabora la rúbrica junto con las personas que entienden el riesgo, no solo con los testers. Los equipos jurídicos, de cumplimiento normativo y de producto suelen detectar escenarios de fallo que el equipo de control de calidad (QA) por sí solo pasaría por alto.
- Mantén los criterios limitados y relevantes. Cinco criterios específicos que realmente sigas son mejores que quince a los que nunca vuelves a prestar atención.
- Revisa los umbrales con regularidad. Lo que se consideraba «suficientemente bueno» en el momento del lanzamiento puede que no se mantenga una vez que el sistema gestione más casos extremos o interacciones de mayor importancia.
- Registra todo, no solo los fallos. Las respuestas correctas que se sitúan justo en el límite de un umbral suelen ser la primera señal de alerta de una desviación.
- Trata un fallo como información, no automáticamente como un bloqueo. El objetivo es la visibilidad, no la parálisis.
¿Adónde nos lleva esto?
La evaluación basada en rúbricas dentro de unos márgenes es la base sobre la que se construye todo lo demás en las pruebas de IA. Es lo que permite decir algo significativo sobre la calidad de un sistema de IA, incluso cuando ese sistema puede expresar las cosas de forma diferente cada vez.
Además, es la técnica que ofrece la mejor relación entre esfuerzo y resultado. No hace falta una infraestructura sofisticada para empezar: con una rúbrica clara, unos cuantos umbrales y la disciplina necesaria para aplicarlos de forma coherente, la mayoría de los equipos ya llegan muy lejos.
Milan Meuleman
Business development y ventas
Contáctanos hoy
Te gustaría tener más control sobre la calidad, la automatización de pruebas y rendimiento de tu software? Estaremos encantados de ayudarte a definir una estrategia que se adapte a tu equipo.